Claude 周额度是怎么反推出来的
把「用量」和「额度百分比」放在同一个坐标系里,用包络法估计 100% 周额度等价于多少 API 参考美元(Q100)。
1. 一句话思路
额度是一个百分比(每周重置,0–100%)。用量可以用 API 公开价格折成美元。于是:若把 100% 额度全部花在某一种用法上,需要多少美元?这个数记为 Q100。
做法:对每个时间区间,记录「我花了多少美元」和「额度掉了几个百分点」。美元 ÷ 百分点 × 100 就是该区间隐含的 Q100。取所有区间里的最大值(包络),得到 Q100 的下界。
为什么取最大值而不是平均:额度只在百分比上量化(整数 1 pp),而美元是连续的。任何一个区间里,落在该区间但计费归到下一个区间的用量都会让 |美元| 相对 |drop| 偏小;只有「美元相对 drop 最大」的那个区间才最接近真实容量。取最大 = 保守下界。
2. 三样输入
三者缺一不可:没有 ① 无法把 token 变成美元;没有 ② 不知道额度掉了多少;没有 ③ 新模型会被静默丢弃(见第 7 节第一条)。
3. 六个计算步骤
Step 1 · 按模型计价
对每条事件套用它自己模型的费率。以 Fable 5.2 为例(USD / MTok):input 8、5m cache write 10、1h cache write 16、cache read 0.20、output 40。Fable 5.1 是 10 / 12.5 / 20 / 0.25 / 50。
注意 cache read 的倍率:Fable 5.2 / Mythos 5.2 与 5.1 都是 input 的 0.025×,而 Opus 5.5 / Sonnet 5.5 是 0.05×。用错倍率会让长上下文会话的估值差一倍。
Step 2 · 切分配额块(block)
把 used% 序列按向下跳变 > 30 pp 切开:每一段是一次重置后的连续计数。所有计算都在块内进行,绝不跨块累加——跨块的 drop 不是同一次消耗。
Step 3 · 剔除边界区间
- 区间任一端 used% ≥
99.5(剩余 0%):计数器饱和,超额消耗不再反映在百分比上 → 剔除。 - 区间任一端 used% ≤
0.5(剩余 100%):新周期起点,上一周期残余计费会落进来 → 剔除。 drop = 0的区间保留:去掉上面两种状态后,「花了不少美元但计数器没动」是真实的上界约束(y = drop+1 = 1 ⇒ Q ≥ 美元 × 100)。
Step 4 · 包络法求 Q
对每个区间与每个聚合窗口(1、2、3、4、5、6 小时,步长 = 窗口/4):
Q_point = 100 × USD(window) / (drop_pp(window) + 1)+1 是量化修正:真实 drop 落在 (drop, drop+1) 之间,取最保守的一端,保证不把两个相差 1 pp 的相邻窗口当成不同容量。
Step 5 · 取最大,并做块级交叉检查
Q_window = max over all windows of Q_point
Q_block  = 100 × USD(block) / (drop(block) + 1)
Q100     ≥ max(Q_window, Q_block)
两个口径必须接近;若差很远,说明块内消耗速率不恒定(模型切换、计划变化),需要解释而不是取大的那个。
Step 6 · 守恒自检
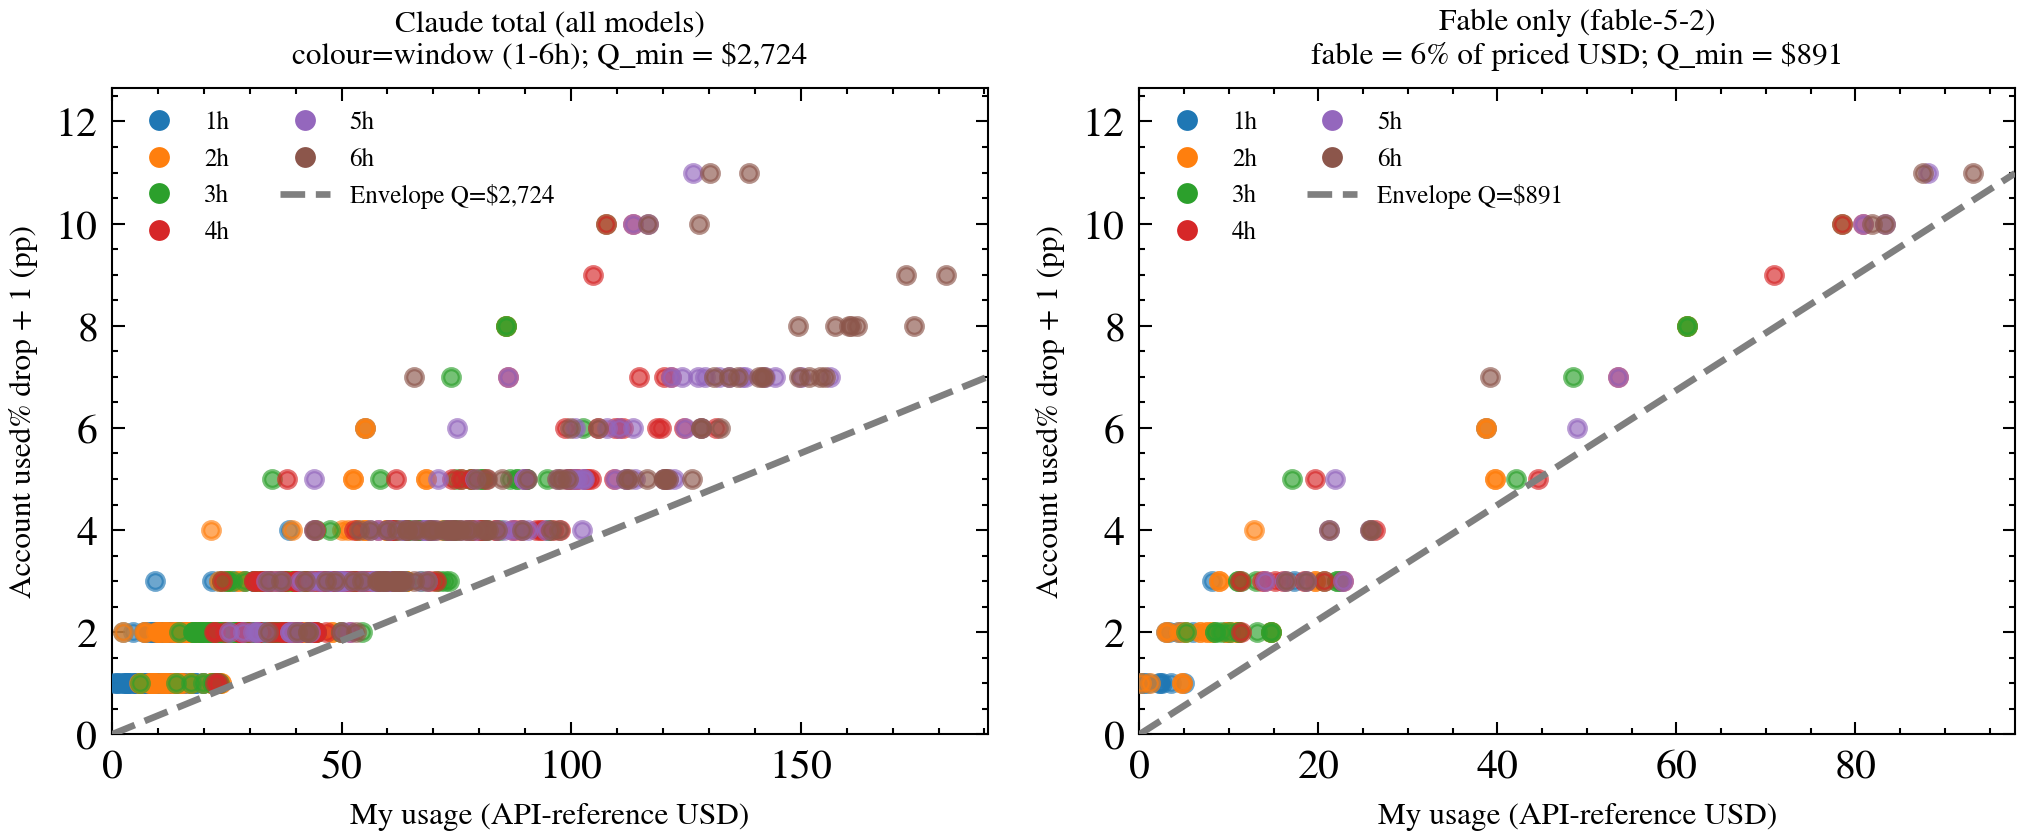
图中所有点都必须落在包络线之上;任何一点落到线下就是计算错误(violations 必须为 0)。另外逐条校验「我的用量 + 他人用量 = 账户用量」,不成立就不发布占比。
4. 为什么这样取数
- 为什么用 API 参考价而不是账单:订阅计划不按 token 出账,唯一可复现的绝对尺度是官方公开价。代价是它假设「API 价格 ∝ 配额扣减」,这个假设必须写在结论旁边。
- 为什么要按 message id 去重:同一轮对话会以多个快照写入 transcript(流式更新),不去重会把用量放大 2–3 倍(实测 1253 条记录 → 619 个 message id)。
- 为什么只读窗口内数据:transcript 是追加写的,一个开了几个月的 session 文件今天仍在被追加。按文件修改时间过滤只能甩掉 7% 的文件;必须按「窗口内出现过的 message id」做行级过滤,才能把处理量降到 7 天该有的水平(内存 3.4 GiB → 1.1 GiB)。
- 为什么用 1–6h 多个窗口:窗口越短越容易受 1 pp 量化影响,越长越容易被中途的模型切换污染。多窗口取最大是一种稳健化。
5. 单独估计 fable 额度
问题:如果只能把额度花在 fable 上,100% 等于多少美元?做法是只把 fable 事件放进分子,分母仍然是账户整体的 drop:
Q_fable = max over windows of 100 × USD_fable(window) / (drop_pp(window) + 1)这一定是个下界,因为同一个 drop 里还有 opus / sonnet 的消耗。所以必须同时报告 fable 在当块用量里的占比:占比 58% 时,Q_fable 只是「全模型 Q」的一部分,不能当作计划容量来读。
同一批 fable token 换不同价格卡会等比例变化:5.1 卡相对 5.2 卡整体贵 25%,因此 Q 也正好差 25%。
6. 当前结果(2026-11-11 快照)
| 口径 | 用量 / 美元 | drop | Q100 | 说明 |
|---|---|---|---|---|
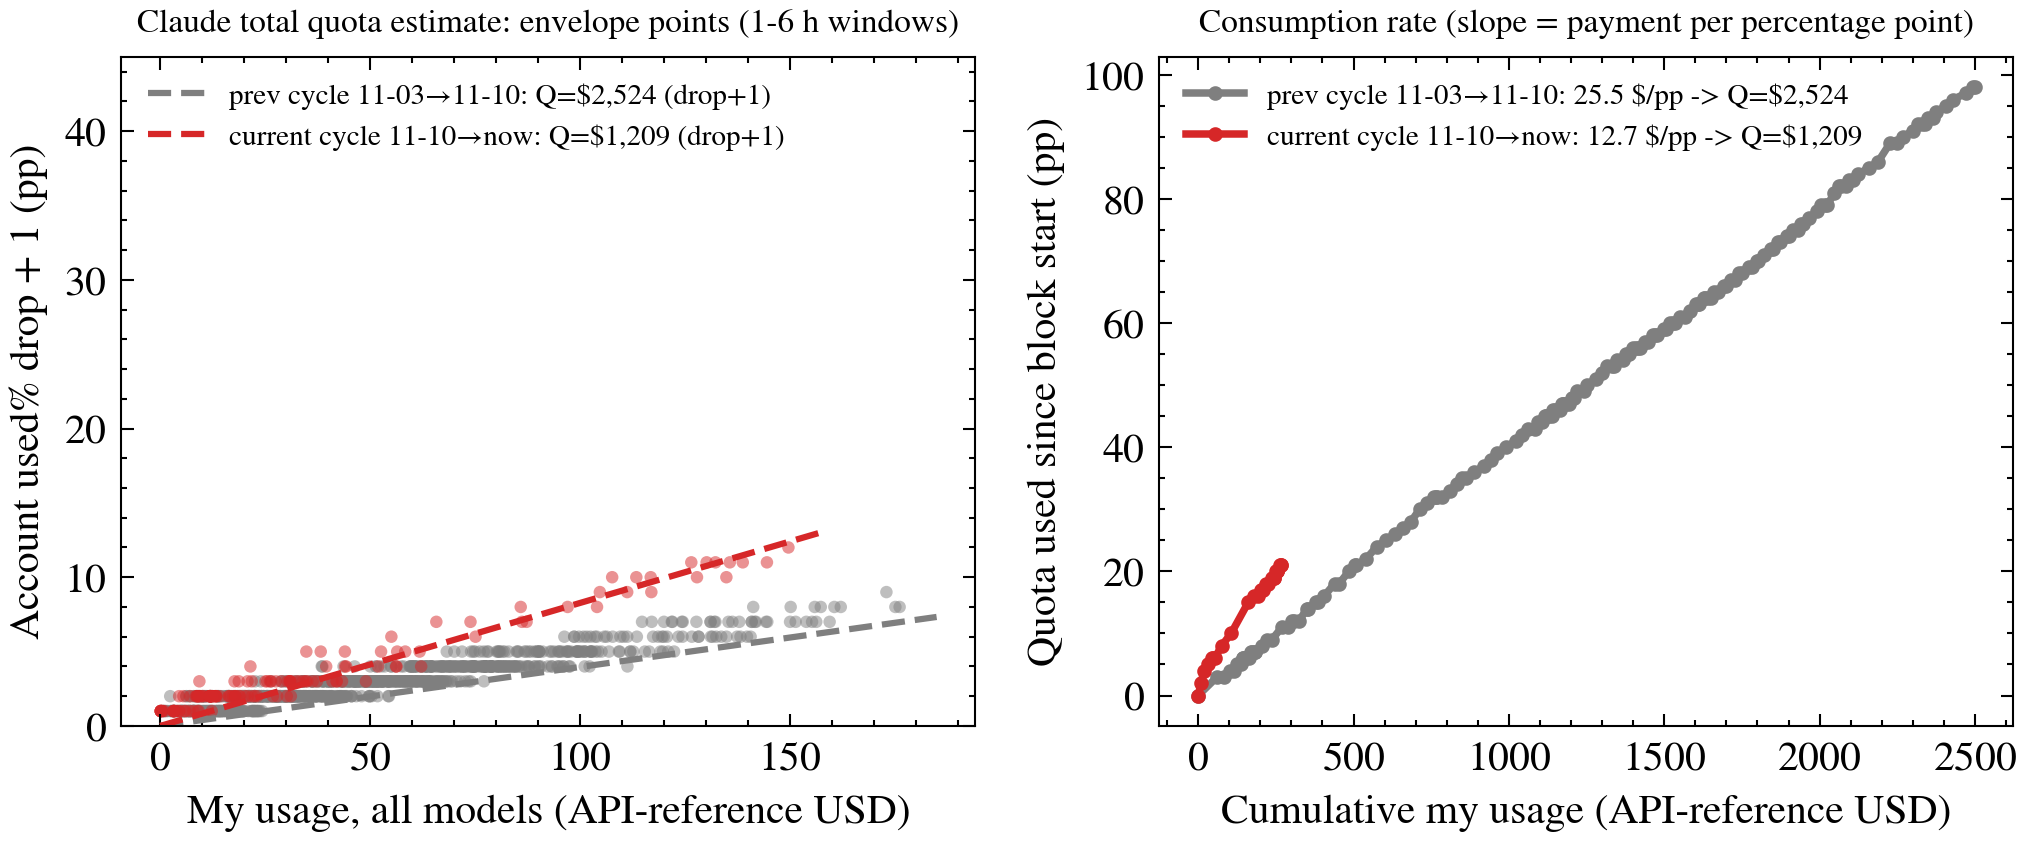
| 上一完整周期(11-03 → 11-10) | 2,498 | 98 pp | $2,524 | 全部模型;窗口包络 $2,782 |
| 本周期(11-10 → 11-11 04:50Z) | 266 | 21 pp | $1,209 | 只走完 21%,块级 ±5% |
| 本周期 fable-only | 154(58%) | 21 pp | $891 | 下界:分母含 opus/sonnet |
关键读法:本周期每 1 pp 额度只买到 12.7 美元用量,上一周期是 25.5 美元。同样掉 1 pp,本周的美元价值少一半——这意味着本周开始模型权重或计划参数发生了变化,而不是数据噪声。
7. 六个常见错误
- 新模型没有价格 → 用量被静默丢弃。价目表里查不到的 model 字符串会被判为 unpriced 并排除在美元总量之外,Q 随之被低估。上线新模型时必须更新价格卡,并检查 unpriced = 0。
- 拿原始消息行直接求和。流式快照会重复计数 2–3 倍;必须先按 message id 取最终快照。
- 把 0% 之后的超额消耗当作样本。计数器卡在 100%,用量与 drop 的关系已经断裂。
- 跨块累加。不同周期的美元不能相加再去比一个块的 Q。
- 用「现在的时刻」当横轴终点。横轴应是周期起点到重置时间。
- 把下界当点估计。Q_min 是下界;用一个新周期的前 20% 推出的 Q 只能当趋势,不能当容量。
8. 复现方式(命令模板)
三段流水线,全部确定性、无交互:
# 1) 抽取窗口内台账(行级过滤:先建窗口内 message id 索引,再保留这些 id 的全部观测行)
python3 freeze_local_ledger.py        # 环境变量:SOURCE / OUT / START / END

# 2) 计价 + 生成包络图(all-model 与 fable-only 两个口径)
python3 claude_envelope_daily.py      # 输出 PNG + manifest.json

# 3) 发布到 Discord / 页面
python3 post_thread.py --thread <id> --text <summary> --image a.png --image b.png校验清单:unpriced == 0、violations == 0、全部点位于包络线上方、块级 Q 与窗口 Q 同量级。
9. 局限与声明
① 全部金额都是 Standard API 参考价,不是账单、不是订阅费、也不证明厂商内部权重。② 方法与数据均来自单账户的本地记录,不含他人设备;缺失设备是「未知」,从不当作 0。③ Q100 是下界,受 1 pp 量化、周期长度和模型混合影响。④ 本页是临时说明,不是任何采购、容量或承诺依据。